场景 1查某个方向近几年的高引用论文
提示词
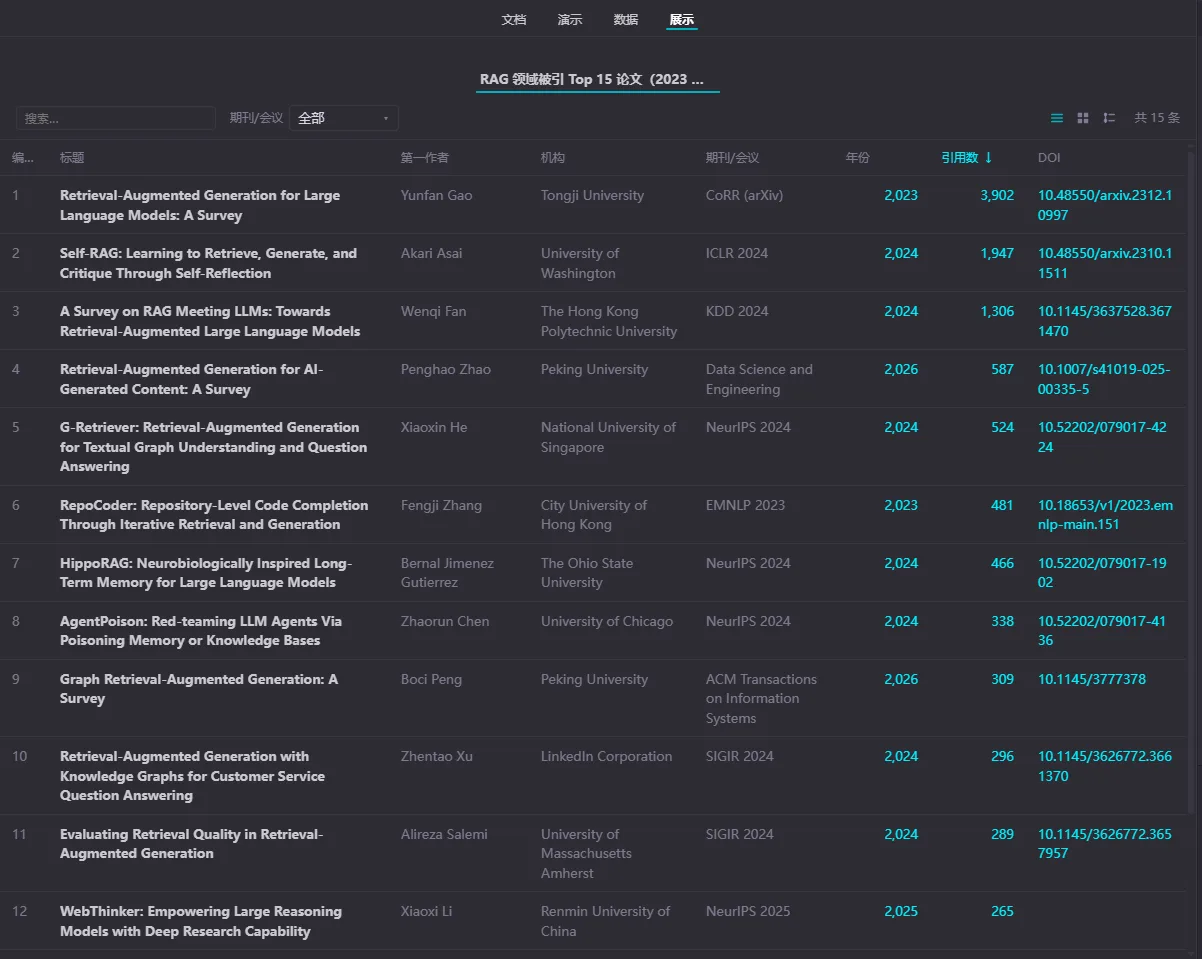
查 2023 年以来 RAG 方向被引最多的 15 篇论文,按引用数从高到低排
场景 2查询论文的引用参考文献
提示词
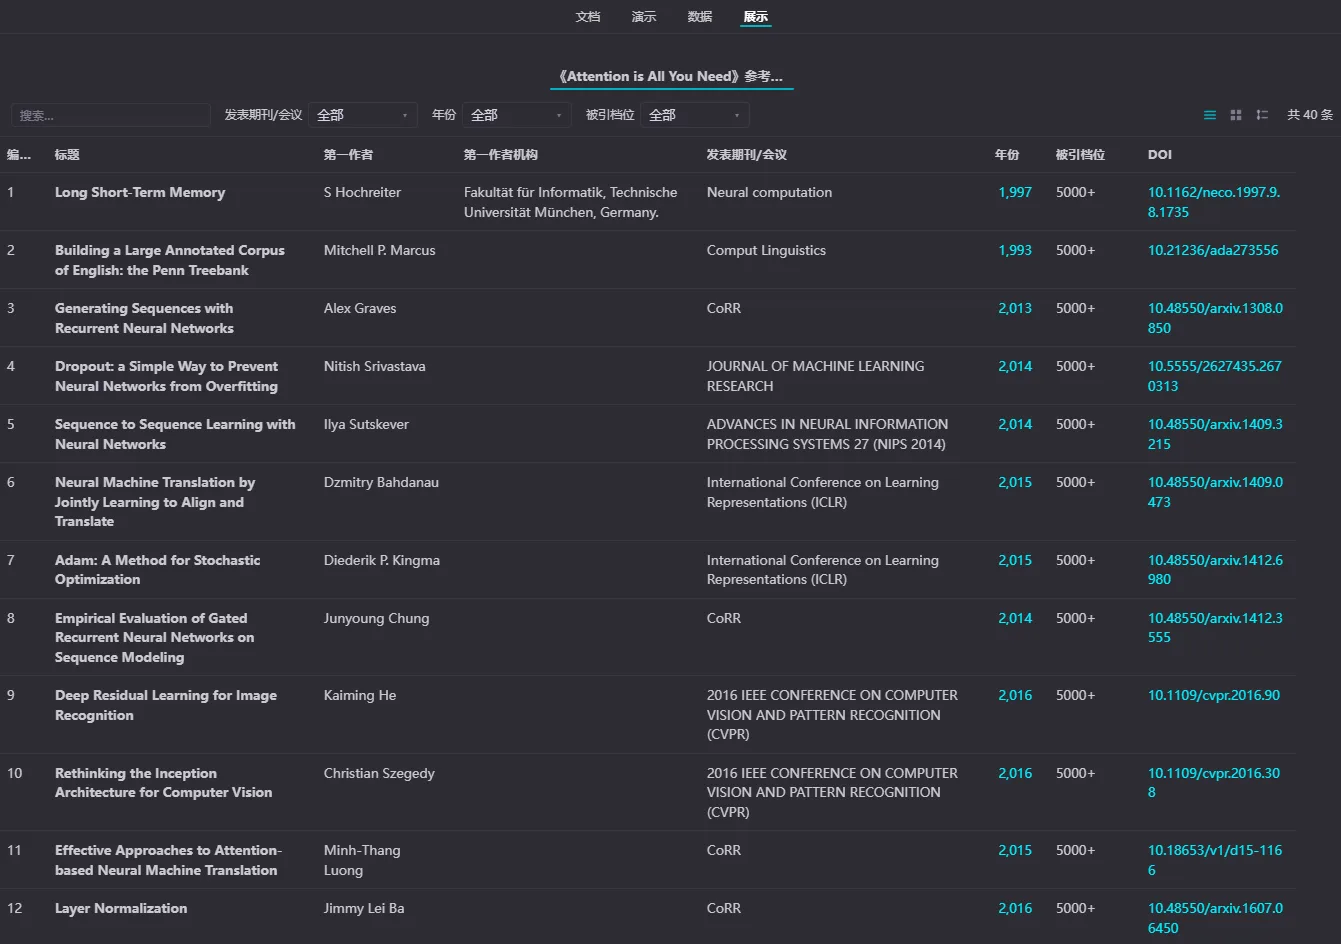
查《Attention Is All You Need》这篇论文引了哪些参考文献
场景 3把检索到的论文原文 PDF 下载到工作区
提示词
找 3 篇 diffusion model 图像生成方向被引最高的论文,能公开下载的把原文 PDF 下到工作区,下不到的把 DOI 链接列出来给我。
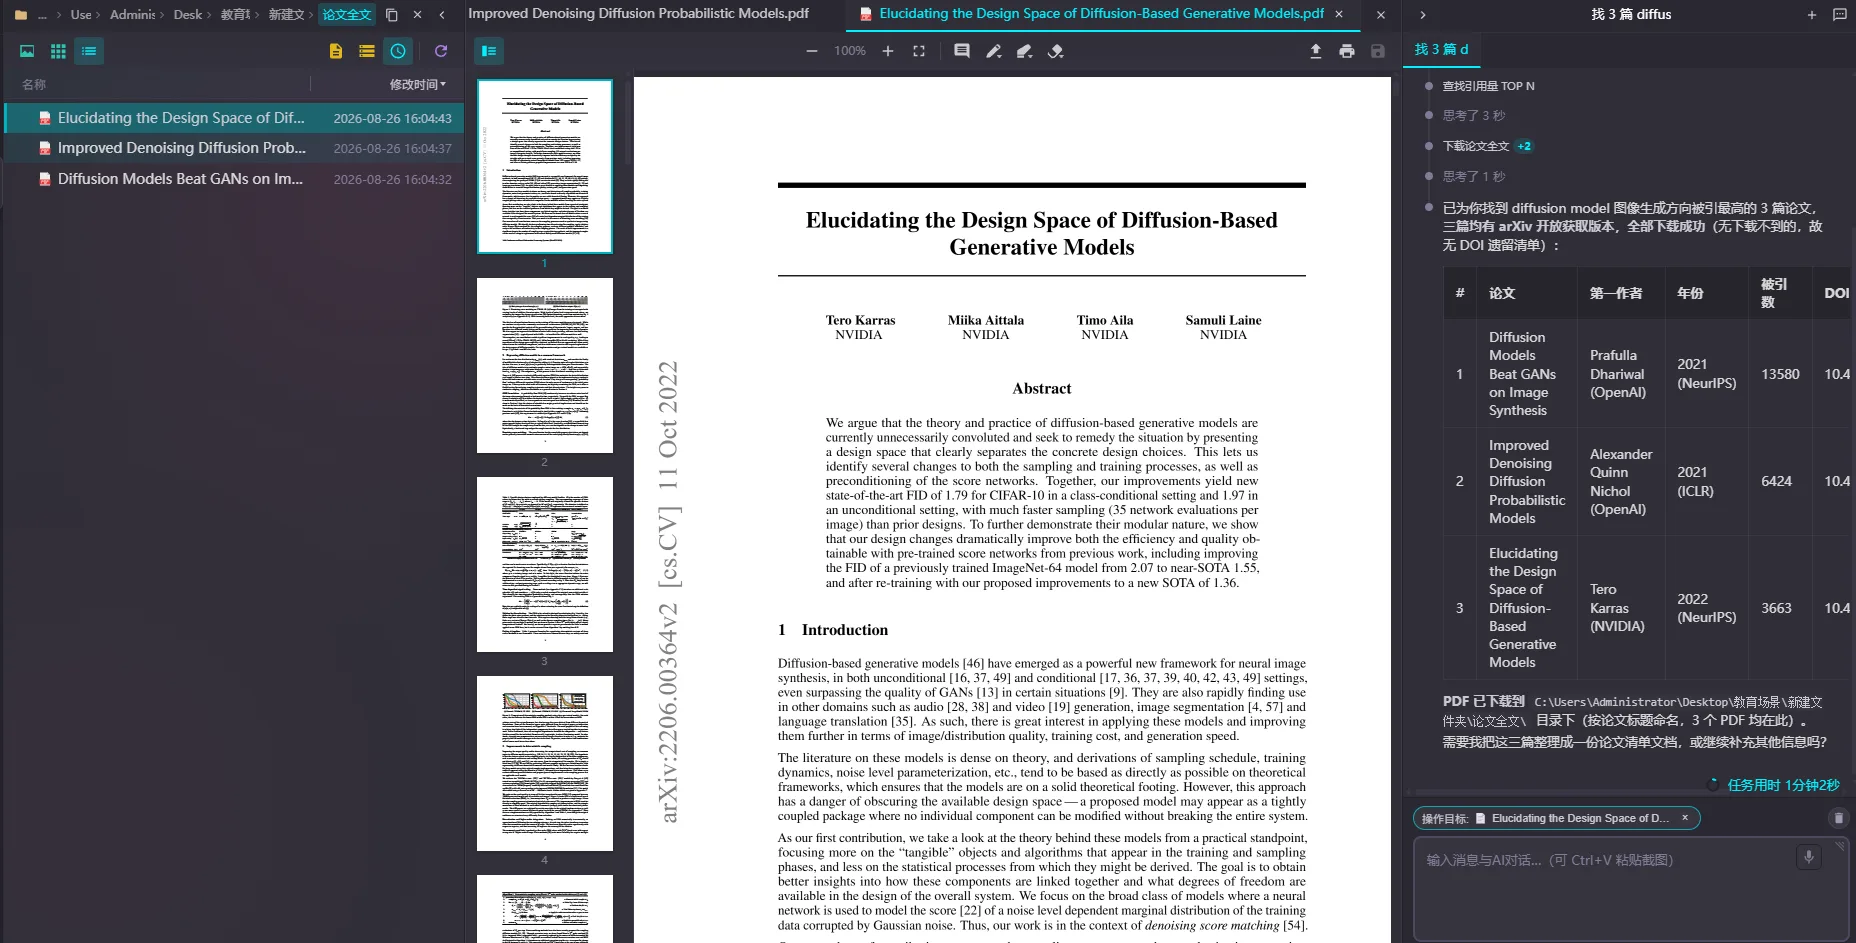
场景 4查一位学者的研究方向、履历与代表作
提示词
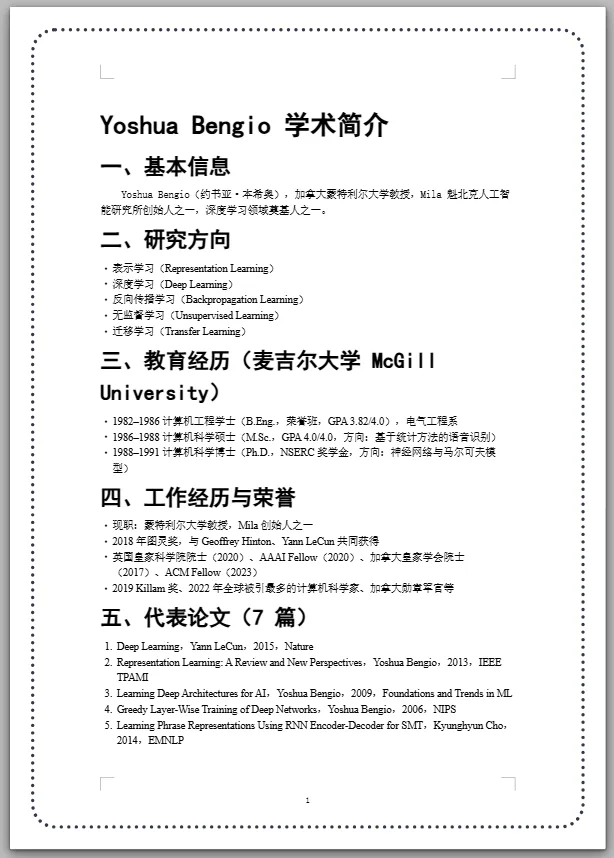
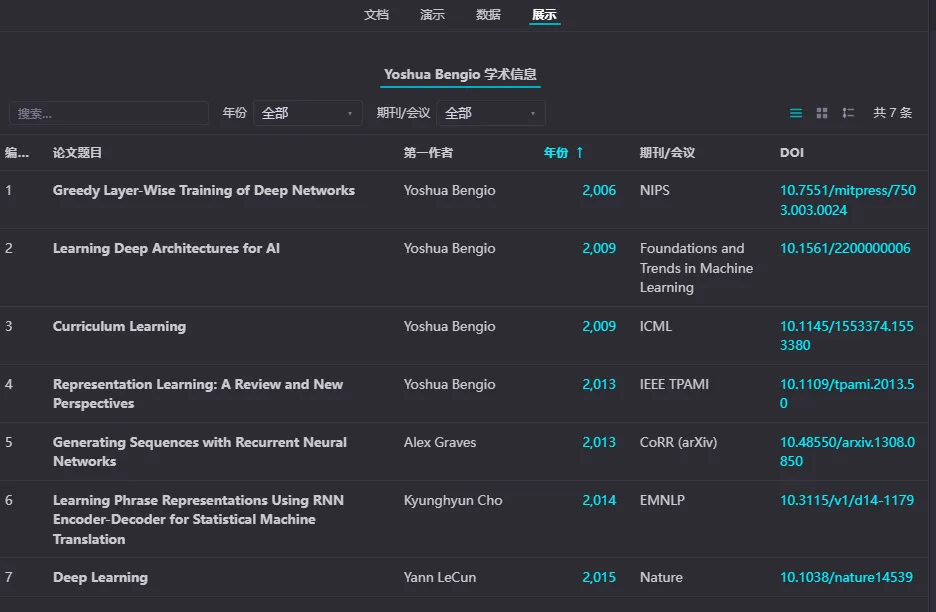
查一下 Yoshua Bengio 的研究方向、教育和工作经历、代表论文和总引用数,整理成一篇文档。
场景 5阅读论文,分析论文内容,写阅读笔记
提示词
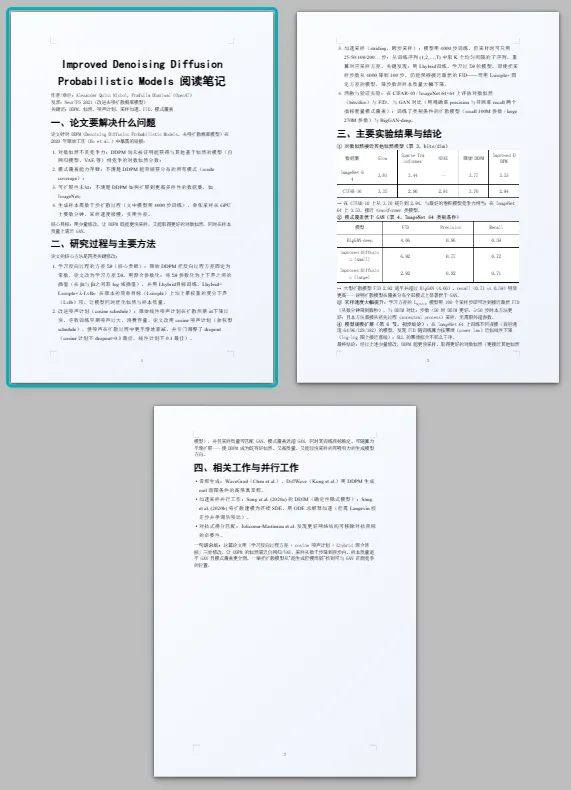
读「Improved Denoising Diffusion Probabilistic Models.pdf」,说清楚它要解决什么问题、研究过程结论是什么?整理成阅读笔记,写成文档
场景 6写文献综述
提示词
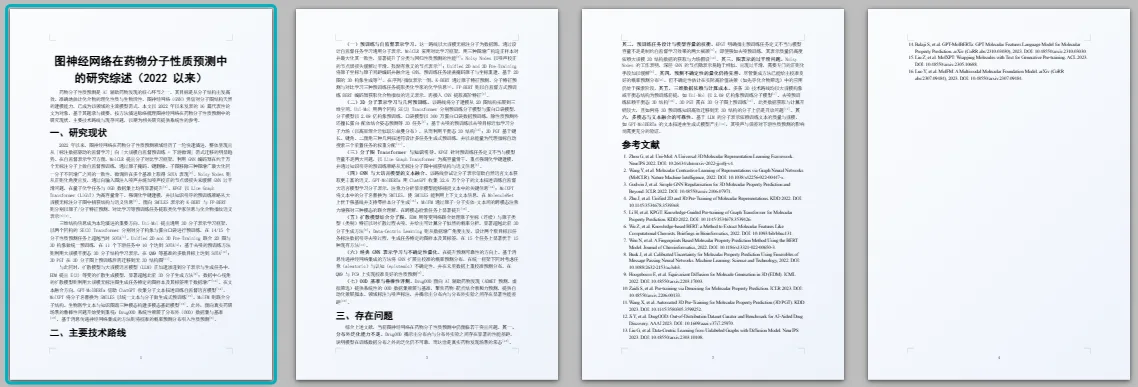
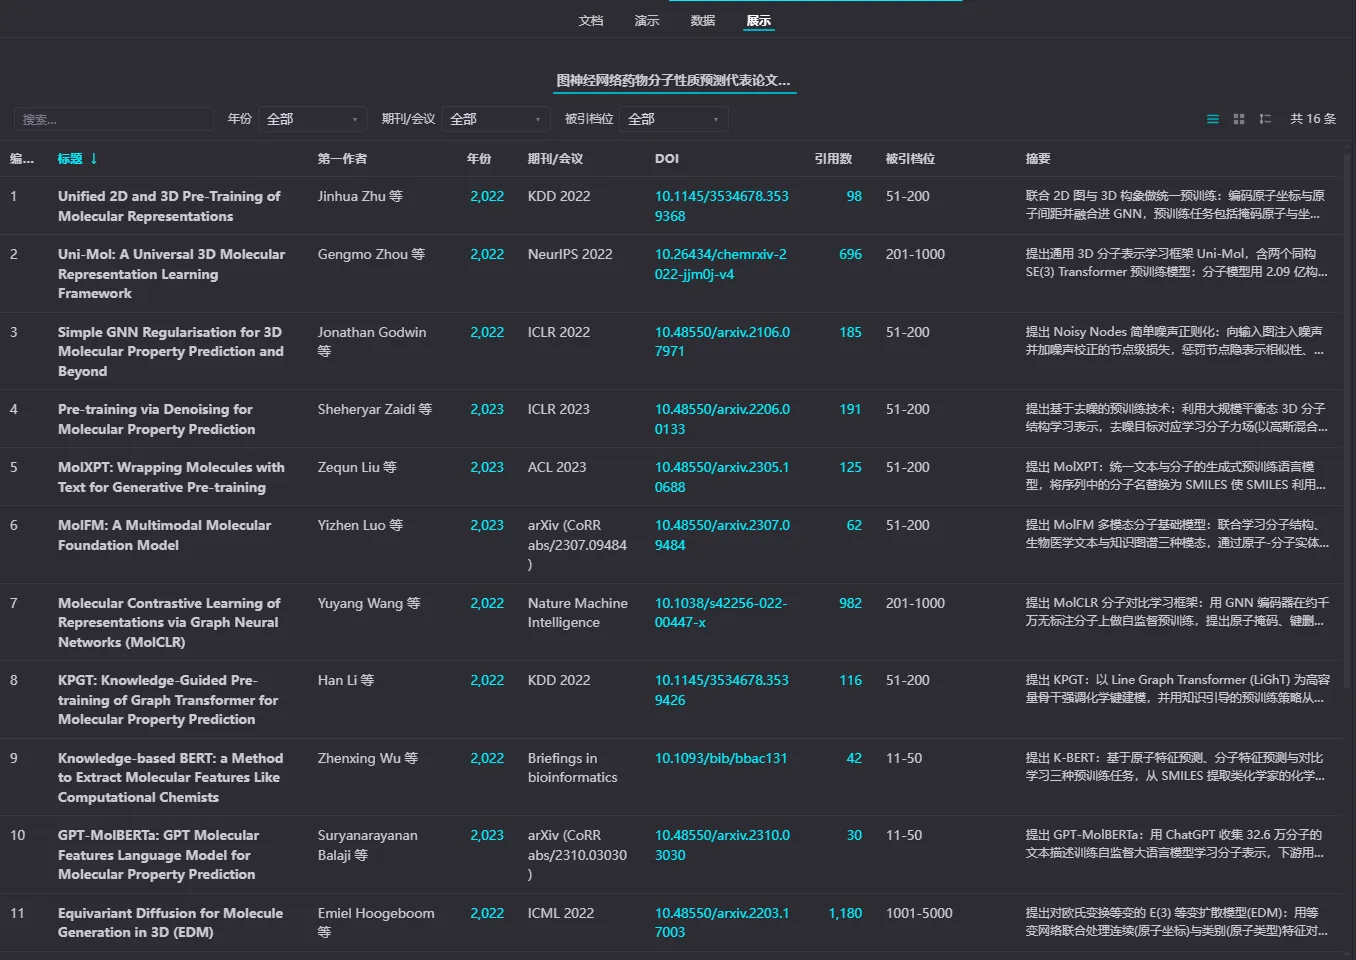
先检索 2022 年以来「图神经网络 药物分子性质预测」方向的论文存成文献清单,再按方法演进的脉络写一篇综述,分研究现状、主要技术路线、存在问题三节。每条具体事实句末打角标,参考文献不要遗漏。
场景 7写开题报告,配技术路线图与进度甘特图
提示词
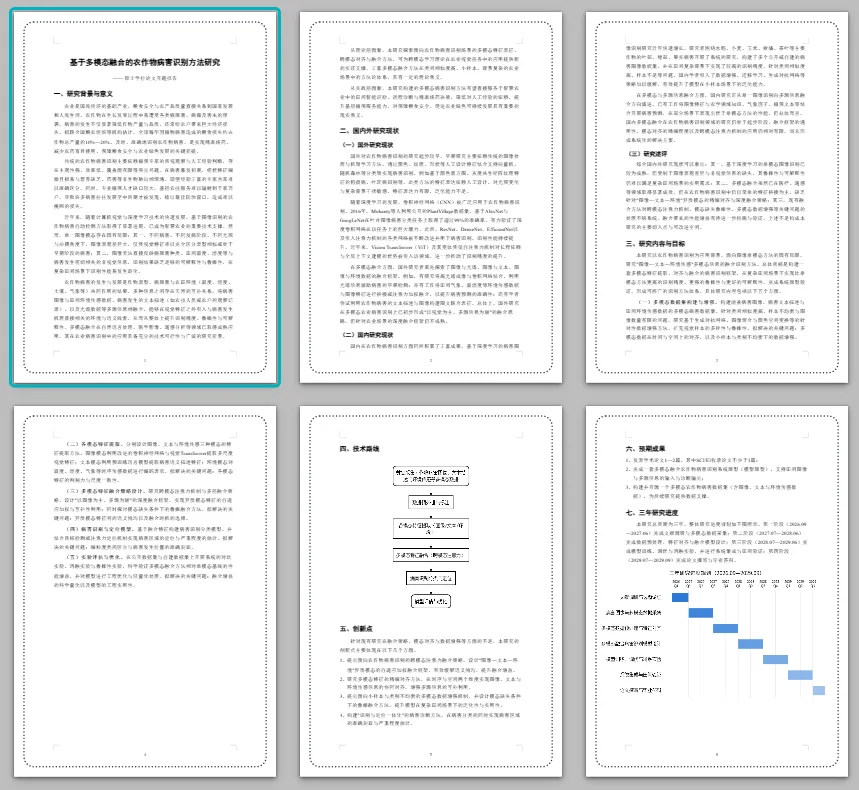
写一份硕士开题报告,题目是「基于多模态融合的农作物病害识别方法研究」:研究背景与意义、国内外研究现状、研究内容与目标、技术路线、创新点、预期成果逐节写。技术路线画成流程图,三年研究进度画成甘特图。
场景 8导入实验数据,计算描述统计与组间差异
提示词
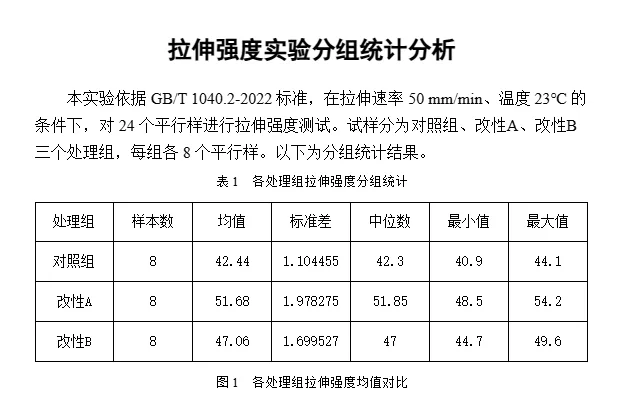
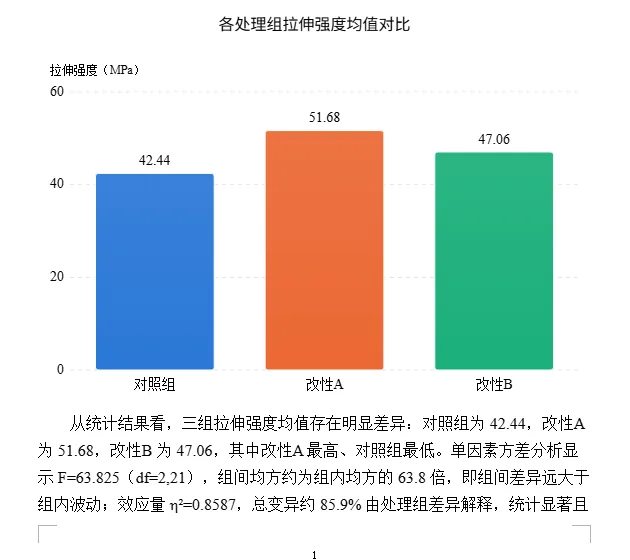
按「拉伸强度实验记录.md」做统计:每个处理组的样本数、均值、标准差、中位数、最小值和最大值都算出来,再看组间差异比组内波动大多少,配一张各组均值对比图。数字按表里算别估。
| 样品编号 | 处理组 | 拉伸强度(MPa) | 断裂伸长率(%) |
| --- | --- | ---: | ---: |
| S01 | 对照组 | 42.6 | 18.4 |
| S02 | 对照组 | 41.8 | 19.1 |
| S03 | 对照组 | 43.5 | 17.6 |
| S04 | 对照组 | 40.9 | 20.3 |
| S05 | 对照组 | 44.1 | 16.8 |
| S06 | 对照组 | 42.0 | 18.9 |
| S07 | 对照组 | 43.2 | 17.2 |
| S08 | 对照组 | 41.4 | 19.7 |
| S09 | 改性A | 51.3 | 14.2 |
| S10 | 改性A | 53.7 | 12.8 |
| S11 | 改性A | 49.8 | 15.6 |
| S12 | 改性A | 52.4 | 13.5 |
| S13 | 改性A | 54.2 | 12.1 |
| S14 | 改性A | 50.6 | 14.9 |
| S15 | 改性A | 52.9 | 13.0 |
| S16 | 改性A | 48.5 | 16.3 |
| S17 | 改性B | 47.2 | 22.5 |
| S18 | 改性B | 46.1 | 23.8 |
| S19 | 改性B | 48.9 | 21.2 |
| S20 | 改性B | 45.3 | 24.6 |
| S21 | 改性B | 49.6 | 20.4 |
| S22 | 改性B | 46.8 | 23.1 |
| S23 | 改性B | 47.9 | 21.9 |
| S24 | 改性B | 44.7 | 25.3 |

测试标准:GB/T 1040.2-2022,拉伸速率 50 mm/min,温度 23℃,每组 8 个平行样
场景 9画标准曲线并标出回归方程与 R²
提示词
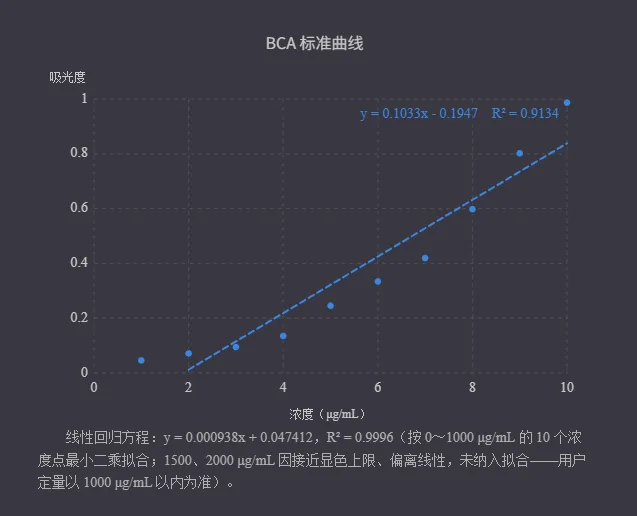
按「标准曲线数据.md」画浓度—吸光度散点图:三个复孔先取平均再画,加线性拟合线,回归方程和 R² 标在图上,横轴写浓度(μg/mL)、纵轴写吸光度。
| 浓度(μg/mL) | A1 | A2 | A3 |
| ---: | ---: | ---: | ---: |
| 0 | 0.047 | 0.042 | 0.049 |
| 25 | 0.071 | 0.068 | 0.075 |
| 50 | 0.094 | 0.099 | 0.091 |
| 100 | 0.138 | 0.131 | 0.137 |
| 200 | 0.249 | 0.241 | 0.247 |
| 300 | 0.328 | 0.341 | 0.333 |
| 400 | 0.419 | 0.428 | 0.412 |
| 600 | 0.601 | 0.589 | 0.604 |
| 800 | 0.802 | 0.788 | 0.816 |
| 1000 | 0.986 | 1.003 | 0.972 |
| 1500 | 1.428 | 1.409 | 1.451 |
| 2000 | 1.812 | 1.836 | 1.789 |

BCA 法测总蛋白,BSA 母液 2 mg/mL 梯度稀释;每孔标准品 20 μL + 工作液 200 μL,37℃ 避光孵育 30 min,562 nm 读数,每个浓度 3 复孔,读数未扣本底。
当日室温 24℃,96 孔板最外圈孔未使用。2000 μg/mL 已接近显色上限,读数偏离线性,定量时以 1000 μg/mL 以内的点为准。
场景 10按组画箱线图,按区间画分布直方图
提示词
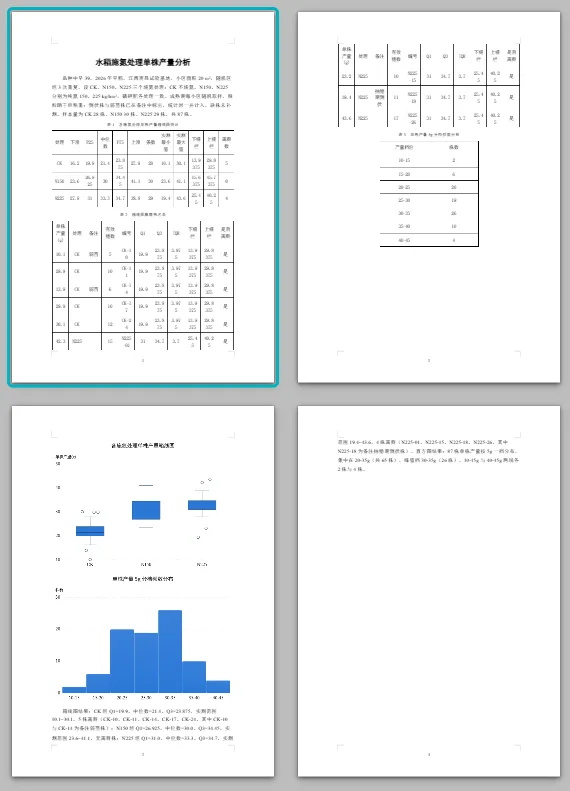
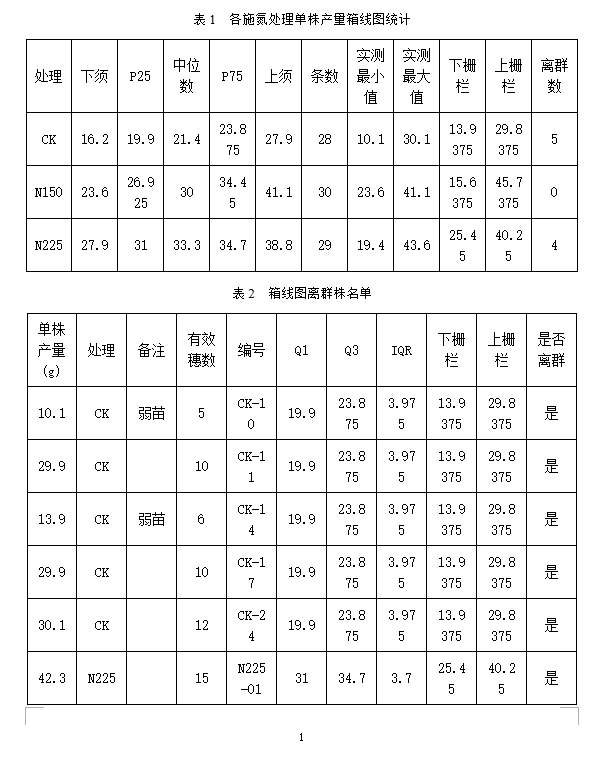
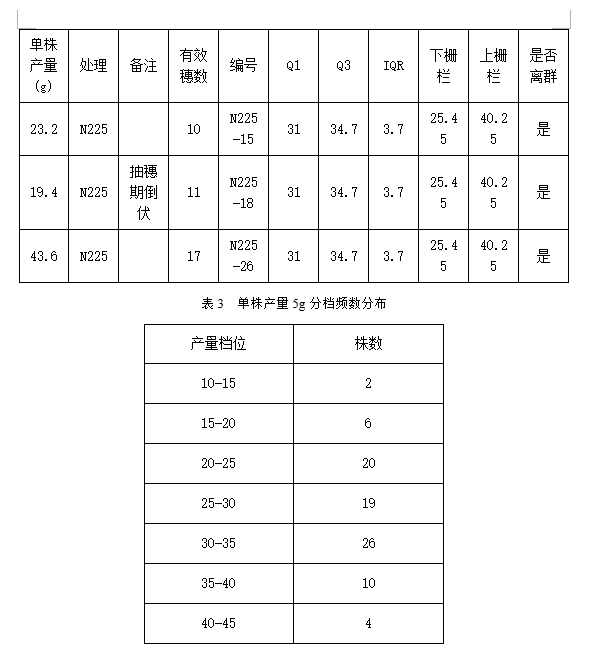
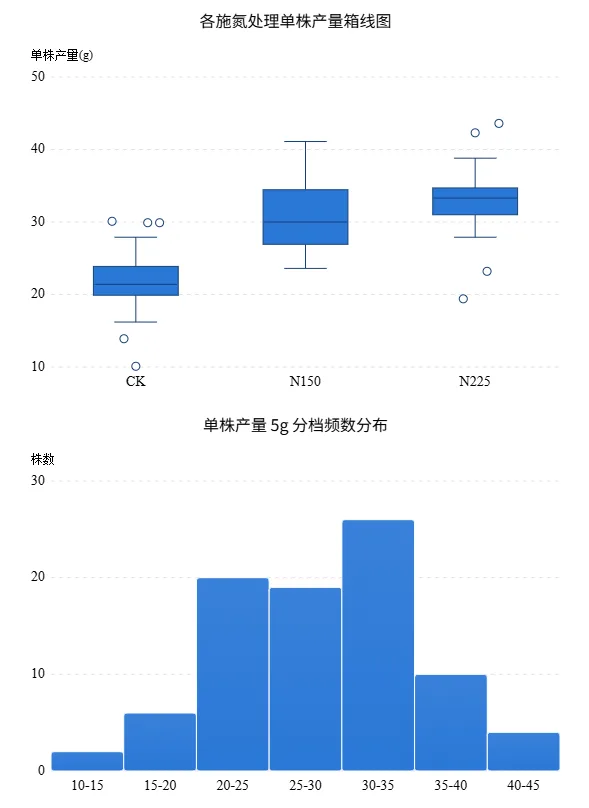
按「水稻单株考种记录.md」给三个施氮处理画单株产量箱线图,最小值、四分位、中位数、最大值都要能读出来,离群株单独标出来;再把全部单株产量按 5 g 一档画分布直方图。
| 编号 | 处理 | 有效穗数 | 单株产量(g) | 备注 |
| --- | --- | ---: | ---: | --- |
| CK-01 | CK | 9 | 21.6 |  |
| CK-02 | CK | 9 | 22.2 |  |
| CK-03 | CK | 10 | 20.4 |  |
| CK-04 | CK | 9 | 20.7 |  |
| CK-05 | CK | 9 | 23.5 |  |
| CK-06 | CK | 8 | 21.9 |  |
| CK-07 | CK | 6 | 16.8 |  |
| CK-08 | CK | 7 | 20.1 |  |
| CK-09 | CK | 10 | 23.8 |  |
| CK-10 | CK | 5 | 10.1 | 弱苗 |
| CK-11 | CK | 10 | 29.9 |  |
| CK-12 | CK | 8 | 19.3 |  |
| CK-13 | CK | 10 | 27.0 |  |
| CK-14 | CK | 6 | 13.9 | 弱苗 |
| CK-15 | CK | 8 | 20.7 |  |
| CK-16 | CK | 8 | 19.6 |  |
| CK-17 | CK | 10 | 29.9 |  |
| CK-18 | CK | 9 | 24.1 |  |
| CK-19 | CK | 9 | 23.6 |  |
| CK-20 | CK | 10 | 24.5 |  |
| CK-21 | CK | 11 | 27.9 |  |
| CK-22 | CK | 9 | 20.0 |  |
| CK-23 | CK | 8 | 22.0 |  |
| CK-24 | CK | 12 | 30.1 |  |
| CK-25 | CK | 8 | 20.2 |  |
| CK-26 | CK | 7 | 16.2 |  |
| CK-27 | CK | 6 | 16.5 |  |
| CK-28 | CK | 7 | 21.2 |  |
| N150-01 | N150 | 13 | 37.8 |  |
| N150-02 | N150 | 12 | 32.4 |  |
| N150-03 | N150 | 15 | 37.3 |  |
| N150-04 | N150 | 13 | 28.2 |  |
| N150-05 | N150 | 12 | 25.8 |  |
| N150-06 | N150 | 13 | 35.2 |  |
| N150-07 | N150 | 11 | 29.8 |  |
| N150-08 | N150 | 10 | 24.0 |  |
| N150-09 | N150 | 12 | 28.5 |  |
| N150-10 | N150 | 9 | 24.9 |  |
| N150-11 | N150 | 12 | 30.2 |  |
| N150-12 | N150 | 15 | 35.4 |  |
| N150-13 | N150 | 10 | 23.6 | 边行 |
| N150-14 | N150 | 13 | 33.4 |  |
| N150-15 | N150 | 11 | 26.3 |  |
| N150-16 | N150 | 14 | 38.2 |  |
| N150-17 | N150 | 11 | 29.7 |  |
| N150-18 | N150 | 12 | 26.7 |  |
| N150-19 | N150 | 14 | 31.3 |  |
| N150-20 | N150 | 10 | 26.2 |  |
| N150-21 | N150 | 15 | 41.1 |  |
| N150-22 | N150 | 14 | 40.0 |  |
| N150-23 | N150 | 11 | 29.7 |  |
| N150-24 | N150 | 11 | 31.5 |  |
| N150-25 | N150 | 10 | 27.0 |  |
| N150-26 | N150 | 14 | 34.8 |  |
| N150-27 | N150 | 12 | 30.4 |  |
| N150-28 | N150 | 14 | 33.1 |  |
| N150-29 | N150 | 11 | 29.7 |  |
| N150-30 | N150 | 11 | 26.9 |  |
| N225-01 | N225 | 15 | 42.3 |  |
| N225-02 | N225 | 15 | 36.3 |  |
| N225-03 | N225 | 13 | 35.0 |  |
| N225-04 | N225 | 13 | 32.0 |  |
| N225-05 | N225 | 14 | 32.8 |  |
| N225-06 | N225 | 13 | 31.9 |  |
| N225-07 | N225 | 13 | 32.6 |  |
| N225-08 | N225 | 11 | 28.6 |  |
| N225-09 | N225 | 12 | 30.3 |  |
| N225-10 | N225 | 15 | 34.4 |  |
| N225-11 | N225 | 14 | 36.4 |  |
| N225-12 | N225 | 15 | 33.3 |  |
| N225-13 | N225 | 13 | 33.5 |  |
| N225-14 | N225 | 15 | 38.8 |  |
| N225-15 | N225 | 10 | 23.2 |  |
| N225-16 | N225 | 14 | 33.4 |  |
| N225-17 | N225 | 12 | 34.2 |  |
| N225-18 | N225 | 11 | 19.4 | 抽穗期倒伏 |
| N225-19 | N225 | 11 | 29.9 |  |
| N225-20 | N225 | 16 | 37.9 |  |
| N225-21 | N225 | 14 | 34.0 |  |
| N225-22 | N225 | 14 | 32.6 |  |
| N225-23 | N225 | 12 | 31.4 |  |
| N225-24 | N225 | 13 | 34.7 |  |
| N225-25 | N225 | 11 | 27.9 |  |
| N225-26 | N225 | 17 | 43.6 |  |
| N225-27 | N225 | 12 | 30.4 |  |
| N225-28 | N225 | 12 | 34.5 |  |
| N225-29 | N225 | 13 | 31.0 |  |

品种中早 39,2026 年早稻,江西南昌试验基地。小区面积 20 m²,随机区组排列 3 次重复,CK 不施氮,N150、N225 分别为纯氮 150、225 kg/hm²,磷钾肥各处理一致。
成熟期每小区随机取样脱粒晒干后称重,倒伏株与弱苗株已在备注中标出,统计时一并计入;缺株未补测。
场景 11用脚本批处理原始数据并回到表中
提示词
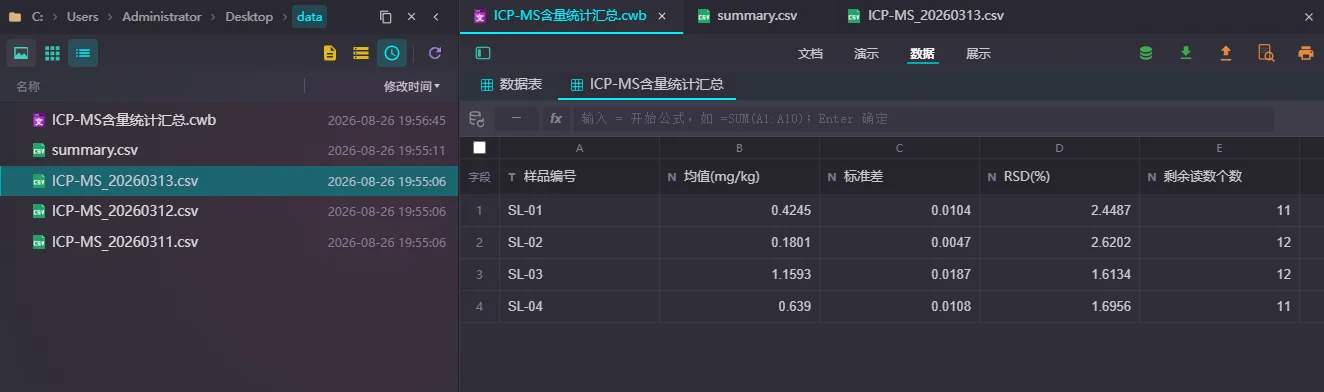
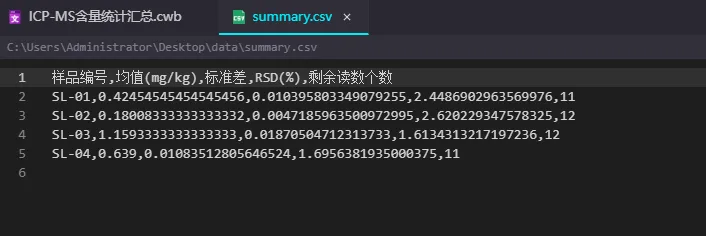
把「ICP-MS原始数据.md」里的三个 csv 按原文件名写到工作区 data 目录下,再写个 Python 脚本:把 data 目录下所有 csv 合并成一张表,按「样品编号」分组,对「含量(mg/kg)」列剔掉偏离组均值 3 倍标准差以上的读数,再算每组剔除后的均值、标准差、相对标准偏差和剩余读数个数,输出成 summary.csv。写完直接跑一下,把剔掉了哪几条、依据是什么告诉我,最后把 summary.csv 的内容回填成表格。
ICP-MS_20260311.csv:

样品编号,读数序号,测定日期,批次号,元素,信号强度(cps),内标回收率(%),含量(mg/kg)
SL-01,1,2026-03-11,B2603-1,Cd111,63550,98.4,0.418
SL-01,2,2026-03-11,B2603-1,Cd111,64600,101.2,0.425
SL-01,3,2026-03-11,B2603-1,Cd111,62650,97.6,0.412
SL-01,4,2026-03-11,B2603-1,Cd111,65500,99.8,0.431
SL-02,1,2026-03-11,B2603-1,Cd111,27250,99.5,0.176
SL-02,2,2026-03-11,B2603-1,Cd111,28150,97.8,0.182
SL-02,3,2026-03-11,B2603-1,Cd111,27700,100.4,0.179
SL-02,4,2026-03-11,B2603-1,Cd111,26950,98.1,0.174
SL-03,1,2026-03-11,B2603-1,Cd111,172150,100.8,1.142
SL-03,2,2026-03-11,B2603-1,Cd111,176050,99.2,1.168
SL-03,3,2026-03-11,B2603-1,Cd111,174100,98.5,1.155
SL-03,4,2026-03-11,B2603-1,Cd111,170500,101.6,1.131
SL-04,1,2026-03-11,B2603-1,Cd111,97000,98.9,0.641
SL-04,2,2026-03-11,B2603-1,Cd111,95050,100.3,0.628
SL-04,3,2026-03-11,B2603-1,Cd111,13150,43.6,0.082
SL-04,4,2026-03-11,B2603-1,Cd111,96100,99.4,0.635

ICP-MS_20260312.csv:

样品编号,读数序号,测定日期,批次号,元素,信号强度(cps),内标回收率(%),含量(mg/kg)
SL-01,1,2026-03-12,B2603-2,Cd111,66250,103.5,0.436
SL-01,2,2026-03-12,B2603-2,Cd111,65200,100.7,0.429
SL-01,3,2026-03-12,B2603-2,Cd111,67000,102.9,0.441
SL-01,4,2026-03-12,B2603-2,Cd111,65800,99.1,0.433
SL-02,1,2026-03-12,B2603-2,Cd111,28600,102.6,0.185
SL-02,2,2026-03-12,B2603-2,Cd111,28000,101.3,0.181
SL-02,3,2026-03-12,B2603-2,Cd111,29050,99.7,0.188
SL-02,4,2026-03-12,B2603-2,Cd111,28300,100.9,0.183
SL-03,1,2026-03-12,B2603-2,Cd111,178300,103.1,1.183
SL-03,2,2026-03-12,B2603-2,Cd111,176500,102.4,1.171
SL-03,3,2026-03-12,B2603-2,Cd111,180250,100.2,1.196
SL-03,4,2026-03-12,B2603-2,Cd111,175450,99.6,1.164
SL-04,1,2026-03-12,B2603-2,Cd111,98650,101.8,0.652
SL-04,2,2026-03-12,B2603-2,Cd111,97900,102.2,0.647
SL-04,3,2026-03-12,B2603-2,Cd111,96700,100.6,0.639
SL-04,4,2026-03-12,B2603-2,Cd111,99550,98.3,0.658

ICP-MS_20260313.csv:

样品编号,读数序号,测定日期,批次号,元素,信号强度(cps),内标回收率(%),含量(mg/kg)
SL-01,1,2026-03-13,B2603-3,Cd111,63100,96.8,0.415
SL-01,2,2026-03-13,B2603-3,Cd111,253300,95.3,1.683
SL-01,3,2026-03-13,B2603-3,Cd111,64000,98.2,0.421
SL-01,4,2026-03-13,B2603-3,Cd111,62200,97.4,0.409
SL-02,1,2026-03-13,B2603-3,Cd111,27400,96.2,0.177
SL-02,2,2026-03-13,B2603-3,Cd111,27850,98.6,0.180
SL-02,3,2026-03-13,B2603-3,Cd111,26650,97.1,0.172
SL-02,4,2026-03-13,B2603-3,Cd111,28450,99.3,0.184
SL-03,1,2026-03-13,B2603-3,Cd111,173050,97.9,1.148
SL-03,2,2026-03-13,B2603-3,Cd111,171700,96.5,1.139
SL-03,3,2026-03-13,B2603-3,Cd111,175150,98.8,1.162
SL-03,4,2026-03-13,B2603-3,Cd111,173800,100.1,1.153
SL-04,1,2026-03-13,B2603-3,Cd111,94150,97.2,0.622
SL-04,2,2026-03-13,B2603-3,Cd111,95950,99.9,0.634
SL-04,3,2026-03-13,B2603-3,Cd111,95200,96.4,0.629
SL-04,4,2026-03-13,B2603-3,Cd111,97450,98.7,0.644

样品经王水消解后定容至 50 mL 上机,称样量 0.2500 g(105℃ 烘干至恒重);Cd111 由 103Rh 内标在线校正,每个样品仪器连续读数 4 次,三个批次共 12 个读数,含量以干重计。校准曲线核查与试剂空白记录另存,不在 data 目录里。
场景 12多张实验图拼成一张图版并标 (a)(b)(c)
提示词
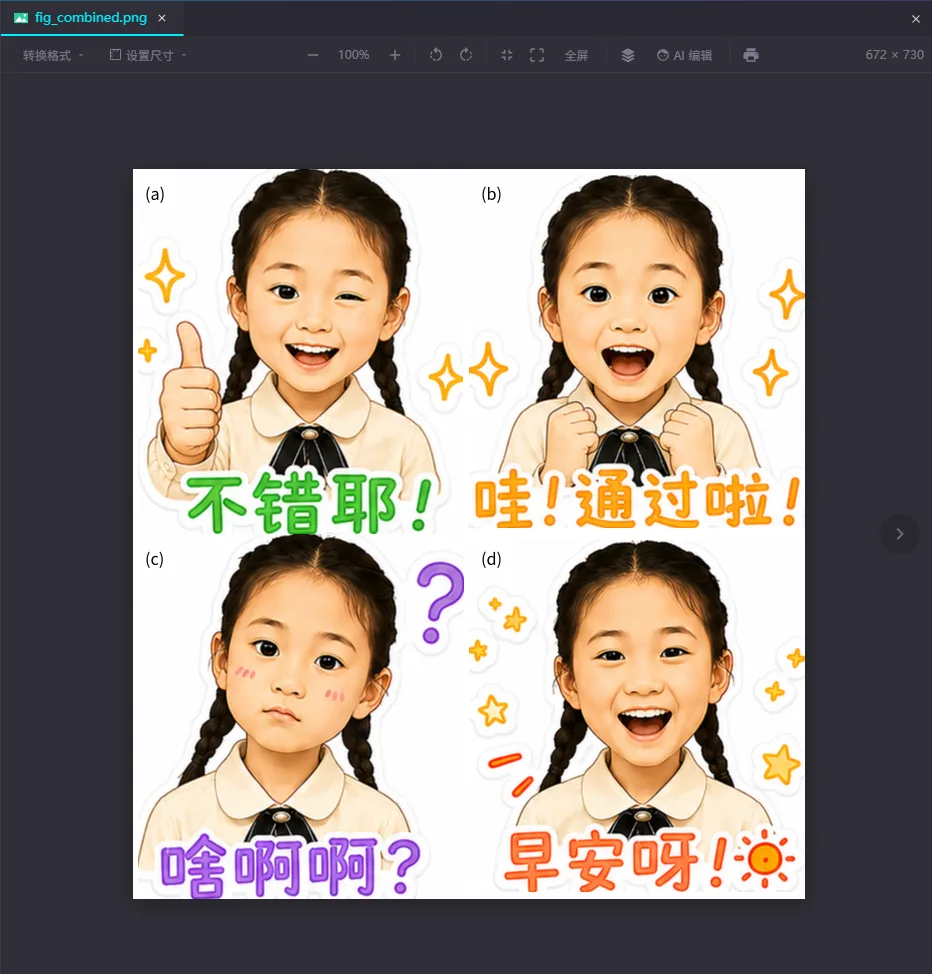
把工作区的 fig1.png、fig2.png、fig3.png、fig4.png 拼成 2×2 的一张图版,四张图尺寸统一,左上角依次标 (a)(b)(c)(d),导出成一张 PNG。
场景 13按问卷答卷做交叉分析
提示词
按「课程满意度问卷.md」做分析:每道题的选项分布先算出来,再按年级和专业分别交叉比对,每题配一张分布图。数字按表里算别估,最后说清哪几项最不满意。
| 编号 | 年级 | 专业 | 总体满意度 | 课程难度 | 作业量 | 最希望改进 |
| --- | --- | --- | --- | --- | --- | --- |
| R01 | 大二 | 计算机 | 满意 | 偏难 | 适中 | 增加实践 |
| R02 | 大二 | 计算机 | 一般 | 偏难 | 偏多 | 减少作业 |
| R03 | 大二 | 电子 | 满意 | 适中 | 适中 | 增加实践 |
| R04 | 大三 | 计算机 | 非常满意 | 适中 | 适中 | 更新案例 |
| R05 | 大三 | 电子 | 一般 | 偏难 | 偏多 | 减少作业 |
| R06 | 大二 | 自动化 | 不满意 | 偏难 | 偏多 | 放慢进度 |
| R07 | 大三 | 计算机 | 满意 | 适中 | 适中 | 增加实践 |
| R08 | 大二 | 电子 | 满意 | 偏难 | 适中 | 更新案例 |
| R09 | 大三 | 自动化 | 一般 | 适中 | 偏多 | 减少作业 |
| R10 | 大二 | 计算机 | 非常满意 | 适中 | 适中 | 增加实践 |
| R11 | 大三 | 电子 | 不满意 | 偏难 | 偏多 | 放慢进度 |
| R12 | 大二 | 自动化 | 满意 | 适中 | 适中 | 更新案例 |
| R13 | 大三 | 计算机 | 满意 | 偏难 | 适中 | 增加实践 |
| R14 | 大二 | 电子 | 一般 | 适中 | 偏多 | 减少作业 |
| R15 | 大三 | 自动化 | 满意 | 适中 | 适中 | 增加实践 |
| R16 | 大二 | 计算机 | 一般 | 偏难 | 偏多 | 放慢进度 |
| R17 | 大三 | 电子 | 非常满意 | 适中 | 适中 | 更新案例 |
| R18 | 大二 | 自动化 | 不满意 | 偏难 | 偏多 | 减少作业 |
| R19 | 大三 | 计算机 | 满意 | 适中 | 适中 | 增加实践 |
| R20 | 大二 | 电子 | 满意 | 适中 | 适中 | 更新案例 |

回收 20 份,有效 20 份,2026 年 6 月发放
场景 14读取 PDF 文档转成可编辑内容
提示词
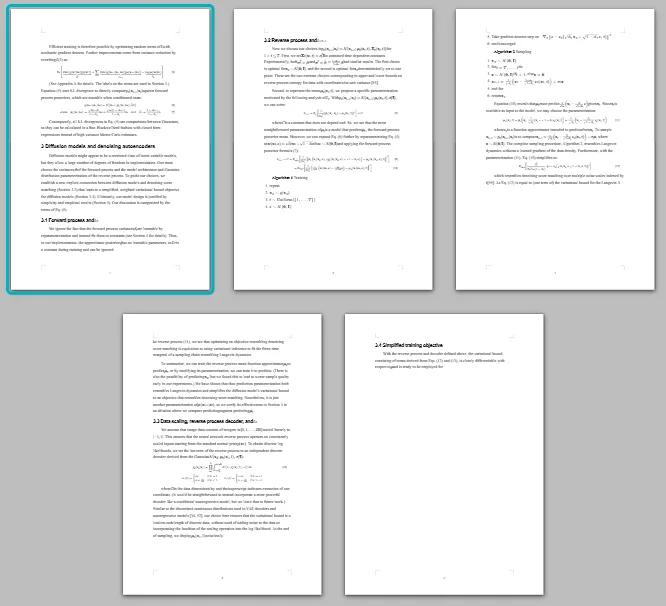
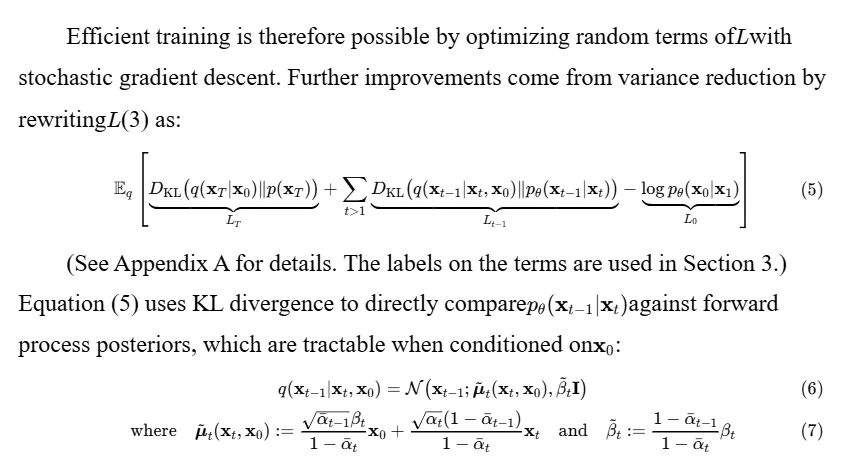
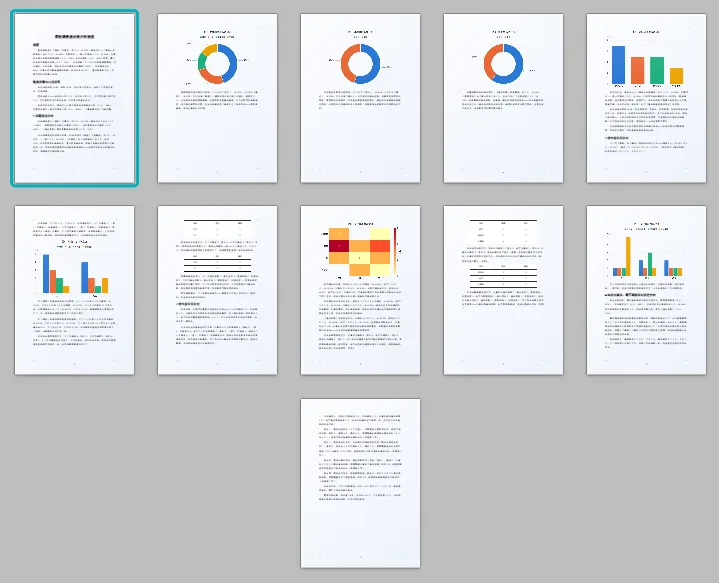
把 PDF 文件中的文字内容和公式复制到文档
输入文件
DDPM 论文第 3-4 页
输出结果
查看 PDF 文件
查看 CWB 文件
效果图
公式渲染细节
正文里行内公式和英文单词之间的空格有丢失(如 random terms ofLwith),转换后要通读一遍补上
V1.8 桌面端